引用循环可能导致内存泄漏
Rust 的内存安全保证使得意外创建永远不会被清理的内存(称为内存泄漏,memory leak)变得困难,但并非不可能。完全防止内存泄漏并不是 Rust 的保证之一,这意味着在 Rust 中内存泄漏是内存安全的。通过使用 Rc<T> 和 RefCell<T>,我们可以看到 Rust 允许内存泄漏:有可能创建相互引用的引用,形成循环。这会造成内存泄漏,因为循环中每个项的引用计数永远不会降到 0,值也永远不会被丢弃。
创建引用循环
让我们看看引用循环是如何发生的,以及如何防止它,首先从 Listing 15-25 中 List 枚举和 tail 方法的定义开始。
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;

#[derive(Debug)]
enum List {
    Cons(i32, RefCell<Rc<List>>),
    Nil,
}

impl List {
    fn tail(&self) -> Option<&RefCell<Rc<List>>> {
        match self {
            Cons(_, item) => Some(item),
            Nil => None,
        }
    }
}

fn main() {}RefCell<T> 的 cons list 定义,这样我们就可以修改 Cons 变体所指向的内容我们使用的是 Listing 15-5 中 List 定义的另一种变体。Cons 变体中的第二个元素现在是 RefCell<Rc<List>>,这意味着我们不想像 Listing 15-24 中那样修改 i32 值,而是想修改 Cons 变体所指向的 List 值。我们还添加了一个 tail 方法,以便在拥有 Cons 变体时方便地访问第二项。
在 Listing 15-26 中,我们添加了一个 main 函数,它使用了 Listing 15-25 中的定义。这段代码在 a 中创建一个列表,并在 b 中创建一个指向 a 列表的列表。然后,它修改 a 中的列表使其指向 b,从而创建一个引用循环。在这个过程中有一些 println! 语句,用来显示各个点的引用计数。
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;

#[derive(Debug)]
enum List {
    Cons(i32, RefCell<Rc<List>>),
    Nil,
}

impl List {
    fn tail(&self) -> Option<&RefCell<Rc<List>>> {
        match self {
            Cons(_, item) => Some(item),
            Nil => None,
        }
    }
}

fn main() {
    let a = Rc::new(Cons(5, RefCell::new(Rc::new(Nil))));

    println!("a initial rc count = {}", Rc::strong_count(&a));
    println!("a next item = {:?}", a.tail());

    let b = Rc::new(Cons(10, RefCell::new(Rc::clone(&a))));

    println!("a rc count after b creation = {}", Rc::strong_count(&a));
    println!("b initial rc count = {}", Rc::strong_count(&b));
    println!("b next item = {:?}", b.tail());

    if let Some(link) = a.tail() {
        *link.borrow_mut() = Rc::clone(&b);
    }

    println!("b rc count after changing a = {}", Rc::strong_count(&b));
    println!("a rc count after changing a = {}", Rc::strong_count(&a));

    // Uncomment the next line to see that we have a cycle;
    // it will overflow the stack.
    // println!("a next item = {:?}", a.tail());
}List 值构成的引用循环我们在变量 a 中创建一个持有 List 值的 Rc<List> 实例,初始列表为 5, Nil。然后,我们在变量 b 中创建另一个持有 List 值的 Rc<List> 实例,它包含值 10 并指向 a 中的列表。
我们修改 a 使其指向 b 而不是 Nil,从而创建一个循环。我们使用 tail 方法获取 a 中 RefCell<Rc<List>> 的引用,将其放入变量 link。然后,我们对 RefCell<Rc<List>> 使用 borrow_mut 方法,将内部的值从持有 Nil 值的 Rc<List> 改为 b 中的 Rc<List>。
当我们运行这段代码时,暂时保持最后一个 println! 被注释掉,我们会得到如下输出:
$ cargo run
   Compiling cons-list v0.1.0 (file:///projects/cons-list)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.53s
     Running `target/debug/cons-list`
a initial rc count = 1
a next item = Some(RefCell { value: Nil })
a rc count after b creation = 2
b initial rc count = 1
b next item = Some(RefCell { value: Cons(5, RefCell { value: Nil }) })
b rc count after changing a = 2
a rc count after changing a = 2
在我们将 a 中的列表改为指向 b 之后,a 和 b 中 Rc<List> 实例的引用计数都是 2。在 main 结束时,Rust 丢弃变量 b,这使 b 的 Rc<List> 实例的引用计数从 2 减少到 1。此时 Rc<List> 在堆上的内存不会被丢弃,因为它的引用计数是 1 而不是 0。然后,Rust 丢弃 a,这使 a 的 Rc<List> 实例的引用计数也从 2 减少到 1。这个实例的内存也无法被丢弃,因为另一个 Rc<List> 实例仍然引用它。分配给列表的内存将永远无法被回收。为了将这个引用循环可视化,我们创建了图 15-4。
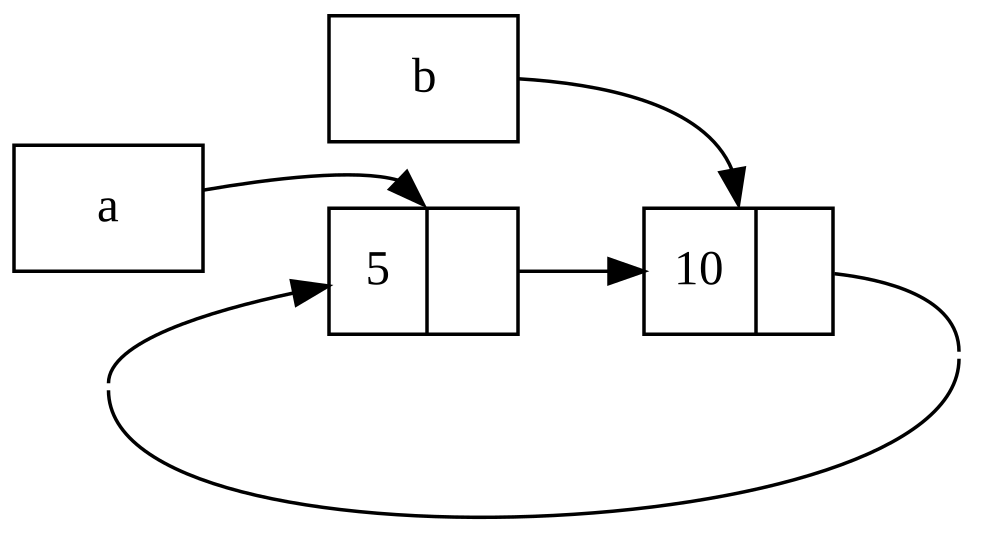
图 15-4:列表 a 和 b 相互指向构成的引用循环
如果你取消注释最后一个 println! 并运行程序,Rust 会尝试打印这个循环:a 指向 b,b 又指向 a,如此往复,直到栈溢出。
与真实世界的程序相比,在这个例子中创建引用循环的后果并不严重:我们创建引用循环之后,程序马上就结束了。然而,如果一个更复杂的程序在循环中分配了大量内存并长时间持有它,程序使用的内存就会超过所需,并可能压垮系统,导致可用内存耗尽。
创建引用循环并不容易,但也并非不可能。如果你有包含 Rc<T> 值的 RefCell<T> 值,或类似的内部可变性与引用计数类型的嵌套组合,你必须确保不会创建循环;你不能依赖 Rust 来捕获它们。创建引用循环将是你程序中的一个逻辑 bug,你应该使用自动化测试、代码评审和其他软件开发实践来尽量减少它。
避免引用循环的另一种解决方案是重新组织你的数据结构,让一些引用表达所有权,而一些引用不表达所有权。这样,你就可以拥有由一些所有权关系和一些非所有权关系组成的循环,并且只有所有权关系影响一个值是否可以被丢弃。在 Listing 15-25 中,我们总是希望 Cons 变体拥有它们的列表,所以重新组织数据结构是不可能的。让我们看一个使用由父节点和子节点组成的图的例子,看看什么时候非所有权关系是防止引用循环的合适方式。
使用 Weak<T> 防止引用循环
到目前为止,我们已经演示了调用 Rc::clone 会增加 Rc<T> 实例的 strong_count,而 Rc<T> 实例只有在其 strong_count 为 0 时才会被清理。你也可以通过调用 Rc::downgrade 并传入对 Rc<T> 的引用来创建对 Rc<T> 实例中值的弱引用(weak reference)。强引用(strong reference)是你共享 Rc<T> 实例所有权的方式。弱引用不表达所有权关系,它们的计数不影响 Rc<T> 实例何时被清理。它们不会导致引用循环,因为一旦所涉及值的强引用计数为 0,任何涉及弱引用的循环都会被打破。
当你调用 Rc::downgrade 时,你会得到一个 Weak<T> 类型的智能指针。调用 Rc::downgrade 不会将 Rc<T> 实例中的 strong_count 增加 1,而是将 weak_count 增加 1。Rc<T> 类型使用 weak_count 来跟踪存在多少个 Weak<T> 引用,类似于 strong_count。区别在于 weak_count 不需要为 0 就能让 Rc<T> 实例被清理。
因为 Weak<T> 引用的值可能已经被丢弃,要对 Weak<T> 所指向的值做任何事情,你必须确保该值仍然存在。通过对 Weak<T> 实例调用 upgrade 方法来做到这一点,它会返回一个 Option<Rc<T>>。如果 Rc<T> 值尚未被丢弃,你会得到 Some;如果 Rc<T> 值已被丢弃,你会得到 None。因为 upgrade 返回 Option<Rc<T>>,Rust 会确保 Some 和 None 两种情况都被处理,不会有无效指针。
举个例子,我们将创建一个树,其中的项知道它们的子项和父项,而不是使用只知道下一项的列表。
创建树形数据结构
首先,我们将构建一个节点知道自己子节点的树。我们将创建一个名为 Node 的结构体,它持有自己的 i32 值以及对其子 Node 值的引用:
文件名:src/main.rs
use std::cell::RefCell;
use std::rc::Rc;

#[derive(Debug)]
struct Node {
    value: i32,
    children: RefCell<Vec<Rc<Node>>>,
}

fn main() {
    let leaf = Rc::new(Node {
        value: 3,
        children: RefCell::new(vec![]),
    });

    let branch = Rc::new(Node {
        value: 5,
        children: RefCell::new(vec![Rc::clone(&leaf)]),
    });
}
我们希望 Node 拥有它的子节点,并且我们想与变量共享这个所有权,以便我们能直接访问树中的每个 Node。为此,我们将 Vec<T> 的项定义为 Rc<Node> 类型的值。我们还想修改哪些节点是另一个节点的子节点,所以我们在 children 中用一个 RefCell<T> 包裹 Vec<Rc<Node>>。
接下来,我们将使用我们的结构体定义,创建一个名为 leaf 的 Node 实例,其值为 3 且没有子节点;再创建一个名为 branch 的实例,其值为 5 并以 leaf 作为子节点之一,如 Listing 15-27 所示。
use std::cell::RefCell;
use std::rc::Rc;

#[derive(Debug)]
struct Node {
    value: i32,
    children: RefCell<Vec<Rc<Node>>>,
}

fn main() {
    let leaf = Rc::new(Node {
        value: 3,
        children: RefCell::new(vec![]),
    });

    let branch = Rc::new(Node {
        value: 5,
        children: RefCell::new(vec![Rc::clone(&leaf)]),
    });
}leaf 节点和一个以 leaf 作为子节点之一的 branch 节点我们克隆 leaf 中的 Rc<Node> 并将其存储在 branch 中,这意味着 leaf 中的 Node 现在有两个所有者:leaf 和 branch。我们可以通过 branch.children 从 branch 到达 leaf,但无法从 leaf 到达 branch。原因是 leaf 没有对 branch 的引用,不知道它们之间的关系。我们希望 leaf 知道 branch 是它的父节点。我们接下来就实现这一点。
添加从子节点到父节点的引用
为了让子节点知道它的父节点,我们需要在 Node 结构体定义中添加一个 parent 字段。麻烦在于确定 parent 的类型应该是什么。我们知道它不能包含 Rc<T>,因为那样会造成引用循环:leaf.parent 指向 branch,而 branch.children 指向 leaf,这会导致它们的 strong_count 值永远不会为 0。
换一种方式思考这些关系:父节点应该拥有它的子节点——如果父节点被丢弃,它的子节点也应该被丢弃。然而,子节点不应该拥有它的父节点——如果我们丢弃一个子节点,父节点应该仍然存在。这正是弱引用的用武之地!
所以,我们将 parent 的类型使用 Weak<T> 而不是 Rc<T>,具体来说是 RefCell<Weak<Node>>。现在我们的 Node 结构体定义如下所示:
文件名:src/main.rs
use std::cell::RefCell;
use std::rc::{Rc, Weak};

#[derive(Debug)]
struct Node {
    value: i32,
    parent: RefCell<Weak<Node>>,
    children: RefCell<Vec<Rc<Node>>>,
}

fn main() {
    let leaf = Rc::new(Node {
        value: 3,
        parent: RefCell::new(Weak::new()),
        children: RefCell::new(vec![]),
    });

    println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());

    let branch = Rc::new(Node {
        value: 5,
        parent: RefCell::new(Weak::new()),
        children: RefCell::new(vec![Rc::clone(&leaf)]),
    });

    *leaf.parent.borrow_mut() = Rc::downgrade(&branch);

    println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}
节点将能够引用它的父节点,但不拥有它的父节点。在 Listing 15-28 中,我们更新 main 以使用这个新定义,使 leaf 节点有办法引用它的父节点 branch。
use std::cell::RefCell;
use std::rc::{Rc, Weak};

#[derive(Debug)]
struct Node {
    value: i32,
    parent: RefCell<Weak<Node>>,
    children: RefCell<Vec<Rc<Node>>>,
}

fn main() {
    let leaf = Rc::new(Node {
        value: 3,
        parent: RefCell::new(Weak::new()),
        children: RefCell::new(vec![]),
    });

    println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());

    let branch = Rc::new(Node {
        value: 5,
        parent: RefCell::new(Weak::new()),
        children: RefCell::new(vec![Rc::clone(&leaf)]),
    });

    *leaf.parent.borrow_mut() = Rc::downgrade(&branch);

    println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}branch 的弱引用的 leaf 节点创建 leaf 节点看起来与 Listing 15-27 类似,除了 parent 字段:leaf 开始时没有父节点,所以我们创建一个新的、空的 Weak<Node> 引用实例。
此时,当我们尝试使用 upgrade 方法获取 leaf 父节点的引用时,会得到一个 None 值。我们在第一个 println! 语句的输出中看到这一点:
leaf parent = None
当我们创建 branch 节点时,它的 parent 字段也会有一个新的 Weak<Node> 引用,因为 branch 没有父节点。我们仍然让 leaf 作为 branch 的子节点之一。一旦我们有了 branch 中的 Node 实例,我们就可以修改 leaf,给它一个指向其父节点的 Weak<Node> 引用。我们对 leaf 的 parent 字段中的 RefCell<Weak<Node>> 使用 borrow_mut 方法,然后使用 Rc::downgrade 函数从 branch 中的 Rc<Node> 创建一个指向 branch 的 Weak<Node> 引用。
当我们再次打印 leaf 的父节点时,这次我们会得到一个持有 branch 的 Some 变体:现在 leaf 可以访问它的父节点了!当我们打印 leaf 时,我们也避免了像 Listing 15-26 那样最终导致栈溢出的循环;Weak<Node> 引用被打印为 (Weak):
leaf parent = Some(Node { value: 5, parent: RefCell { value: (Weak) },
children: RefCell { value: [Node { value: 3, parent: RefCell { value: (Weak) },
children: RefCell { value: [] } }] } })
没有无限输出表明这段代码没有创建引用循环。我们也可以从调用 Rc::strong_count 和 Rc::weak_count 得到的值看出这一点。
可视化 strong_count 和 weak_count 的变化
让我们通过创建一个新的内部作用域并将 branch 的创建移入该作用域,来看看 Rc<Node> 实例的 strong_count 和 weak_count 值是如何变化的。这样,我们就能看到 branch 被创建以及它在离开作用域时被丢弃时会发生什么。这些修改显示在 Listing 15-29 中。
use std::cell::RefCell;
use std::rc::{Rc, Weak};

#[derive(Debug)]
struct Node {
    value: i32,
    parent: RefCell<Weak<Node>>,
    children: RefCell<Vec<Rc<Node>>>,
}

fn main() {
    let leaf = Rc::new(Node {
        value: 3,
        parent: RefCell::new(Weak::new()),
        children: RefCell::new(vec![]),
    });

    println!(
        "leaf strong = {}, weak = {}",
        Rc::strong_count(&leaf),
        Rc::weak_count(&leaf),
    );

    {
        let branch = Rc::new(Node {
            value: 5,
            parent: RefCell::new(Weak::new()),
            children: RefCell::new(vec![Rc::clone(&leaf)]),
        });

        *leaf.parent.borrow_mut() = Rc::downgrade(&branch);

        println!(
            "branch strong = {}, weak = {}",
            Rc::strong_count(&branch),
            Rc::weak_count(&branch),
        );

        println!(
            "leaf strong = {}, weak = {}",
            Rc::strong_count(&leaf),
            Rc::weak_count(&leaf),
        );
    }

    println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
    println!(
        "leaf strong = {}, weak = {}",
        Rc::strong_count(&leaf),
        Rc::weak_count(&leaf),
    );
}branch 并检查强弱引用计数在 leaf 创建之后,它的 Rc<Node> 的强计数为 1,弱计数为 0。在内部作用域中,我们创建 branch 并将其与 leaf 关联起来,此时当我们打印计数时,branch 中的 Rc<Node> 的强计数为 1,弱计数为 1(因为 leaf.parent 用 Weak<Node> 指向 branch)。当我们打印 leaf 中的计数时,我们会看到它的强计数为 2,因为 branch 现在在 branch.children 中存储了 leaf 的 Rc<Node> 的克隆,但弱计数仍然为 0。
当内部作用域结束时,branch 离开作用域,Rc<Node> 的强计数减少为 0,所以它的 Node 被丢弃。来自 leaf.parent 的弱计数 1 与 Node 是否被丢弃无关,所以我们不会得到任何内存泄漏!
如果我们在作用域结束后尝试访问 leaf 的父节点,我们会再次得到 None。在程序结束时,leaf 中的 Rc<Node> 的强计数为 1,弱计数为 0,因为变量 leaf 再次成为 Rc<Node> 的唯一引用。
管理计数和值丢弃的所有逻辑都内置于 Rc<T> 和 Weak<T> 以及它们对 Drop trait 的实现中。通过在 Node 的定义中指定从子节点到父节点的关系应该是 Weak<T> 引用,你就能够让父节点指向子节点,反之亦然,而不会创建引用循环和内存泄漏。
总结
本章介绍了如何使用智能指针来做出不同于 Rust 默认对常规引用所做的保证和权衡。Box<T> 类型具有已知的大小并指向分配在堆上的数据。Rc<T> 类型跟踪堆上数据的引用数量,以便数据可以有多个所有者。RefCell<T> 类型及其内部可变性给了我们一个可以在需要不可变类型但又需要修改该类型内部值时使用的类型;它还在运行时而不是编译时强制执行借用规则。
本章还讨论了 Deref 和 Drop trait,它们实现了智能指针的很多功能。我们探讨了可能导致内存泄漏的引用循环,以及如何使用 Weak<T> 来防止它们。
如果本章激发了你的兴趣,并且你想实现自己的智能指针,请查阅 《Rust 秘典》(The Rustonomicon)获取更多有用的信息。
接下来,我们将讨论 Rust 中的并发。你甚至会学到几个新的智能指针。