什么是所有权?
所有权是一组规则,用于管理 Rust 程序如何使用内存。所有程序在运行时都必须管理计算机内存的使用方式。一些语言会在程序运行期间通过垃圾回收定期查找不再使用的内存;另一些语言则要求程序员显式分配和释放内存。Rust 采用第三种方式:通过一套由编译器检查的所有权规则管理内存。如果违反了其中任何规则,程序就无法编译。所有权机制不会拖慢程序的运行速度。
所有权对许多程序员来说是一个新概念,因此需要一些时间来适应。好消息是,你对 Rust 和所有权规则越熟悉,就越容易自然而然地编写出安全、高效的代码。继续练习!
理解所有权后,你就为掌握 Rust 的独特特性打下了坚实基础。本章会通过一些示例讲解所有权,示例将围绕一种非常常见的数据结构展开:字符串。
栈与堆
许多编程语言并不要求你经常考虑栈和堆。但在 Rust 这样的系统编程语言中,值位于栈还是堆上会影响语言的行为,也会影响你需要做出的某些选择。本章稍后会结合栈和堆来讲解部分所有权概念,因此这里先做简要说明。
栈和堆都是程序运行时可用的内存区域,但组织方式不同。栈按照接收值的顺序存储它们,并以相反的顺序移除。这称为后进先出(LIFO)。可以把它想象成一摞盘子:添加盘子时放在最上面,需要盘子时也从最上面取。在中间或底部添加、取出盘子就没那么方便了!向栈中添加数据称为压栈,移除数据称为出栈。存储在栈上的所有数据都必须具有已知且固定的大小。编译时大小未知或大小可能变化的数据则必须存储在堆上。
堆的组织方式不那么规整:将数据放入堆时,你需要申请一定数量的空间。内存分配器会在堆中找到足够大的空闲位置,将其标记为正在使用,并返回一个指针,也就是该位置的地址。这个过程称为在堆上分配,有时也简称为分配(向栈中压入值不算分配)。由于堆指针的大小已知且固定,你可以将指针存储在栈上;但要访问实际数据时,必须沿着指针找到它。可以想象自己在餐厅就座:进入餐厅时,你说明一行有几个人,接待员会找到一张足够大的空桌并带你过去。如果同行的人晚些到,他们可以询问你们坐在哪里来找到你们。
向栈中压入数据比在堆上分配更快,因为分配器无需搜索存放新数据的位置;该位置始终在栈顶。相比之下,在堆上分配空间需要更多工作:分配器必须先找到足够大的空间来存放数据,然后进行簿记,为下一次分配做准备。
访问堆中的数据通常比访问栈中的数据慢,因为你必须沿着指针才能找到它。现代处理器在内存中跳转较少时速度更快。继续使用餐厅的比喻:服务员要为许多桌子点餐,先完成一张桌子的所有点单,再去下一张桌子,效率最高。先为 A 桌点一份,再为 B 桌点一份,然后又回到 A 桌、再回到 B 桌,会慢得多。同样,处理器通常也能更好地处理彼此相邻的数据(如栈上的数据),而不是距离较远的数据(如堆上的数据)。
代码调用函数时,传入函数的值(可能包括指向堆中数据的指针)以及函数的局部变量都会被压入栈中。函数结束时,这些值会从栈中弹出。
跟踪代码的哪些部分正在使用堆中的哪些数据、尽量减少堆中的重复数据,以及清理堆中不再使用的数据以避免耗尽空间,都是所有权要解决的问题。理解所有权后,你就不必经常考虑栈和堆。不过,了解所有权的主要用途是管理堆数据,有助于解释它为何如此运作。
所有权规则
首先,来看一下所有权规则。阅读后续示例时,请记住以下规则:
- Rust 中的每个值都有一个所有者。
- 同一时刻,一个值只能有一个所有者。
- 所有者离开作用域时,该值会被丢弃。
变量作用域
既然已经学过 Rust 的基础语法,后续示例就不再包含完整的 fn main() { 代码。如果你跟着练习,请记得手动将下面的示例放入 main 函数中。这样示例会更简洁,让我们专注于实际细节,而不是样板代码。
作为所有权的第一个示例,我们来看看一些变量的作用域。作用域是程序中某个条目有效的范围。看下面这个变量:
#![allow(unused)]
fn main() {
let s = "hello";
}
变量 s 指向一个字符串字面量,其值被硬编码在程序文本中。从声明开始直到当前作用域结束,该变量都有效。代码清单 4-1 在程序中用注释标出了变量 s 的有效范围。
fn main() {
    {                      // s is not valid here, since it's not yet declared
        let s = "hello";   // s is valid from this point forward

        // do stuff with s
    }                      // this scope is now over, and s is no longer valid
}换句话说,这里有两个重要的时间点:
s进入作用域时,它开始有效。- 它会一直有效,直到离开作用域。
到目前为止,作用域与变量有效时间之间的关系和其他编程语言类似。现在,我们将在此基础上介绍 String 类型。
String 类型
为了说明所有权规则,我们需要一种比第 3 章“数据类型”一节介绍的类型更复杂的数据类型。之前介绍的类型大小已知,可以存储在栈上,并在作用域结束时从栈中弹出;如果代码的其他部分需要在另一个作用域中使用相同的值,也可以快速、简单地复制出一个独立实例。但我们想了解存储在堆上的数据,并探索 Rust 如何知道何时清理这些数据;String 类型就是一个很好的例子。
我们会重点介绍 String 中与所有权相关的部分。这些方面也适用于其他复杂数据类型,无论它们来自标准库还是由你创建。关于 String 的其他内容,我们会在第 8 章讨论。
我们已经见过字符串字面量,它的值被硬编码在程序中。字符串字面量使用方便,但并不适用于所有文本场景。一个原因是它们不可变;另一个原因是,编写代码时并不总能提前知道每个字符串的值。例如,如果我们想接收并存储用户输入,该怎么办?Rust 为这类情况提供了 String 类型。它管理分配在堆上的数据,因此能够存储编译时大小未知的文本。你可以使用 from 函数从字符串字面量创建 String,如下所示:
#![allow(unused)]
fn main() {
let s = String::from("hello");
}
双冒号运算符 :: 让我们可以将这个特定的 from 函数归属到 String 类型的命名空间中,而不必使用类似 string_from 这样的名称。我们会在第 5 章“方法”一节,以及第 7 章讨论模块命名空间的“用于引用模块树中条目的路径”一节中进一步介绍这种语法。
这种字符串可以修改:
fn main() {
    let mut s = String::from("hello");

    s.push_str(", world!"); // push_str() appends a literal to a String

    println!("{s}"); // this will print `hello, world!`
}
那么这里有什么不同呢?为什么 String 可以修改,而字符串字面量不行?区别在于这两种类型处理内存的方式不同。
内存与分配
对于字符串字面量,编译时我们就知道它的内容,因此文本会直接硬编码在最终可执行文件中。这就是字符串字面量快速、高效的原因。不过,这些特性依赖于字符串字面量不可变这一点。遗憾的是,对于编译时大小未知、且运行过程中可能改变的文本,我们无法为每一段文本都在二进制文件中预留一块内存。
为了让 String 支持可变、可增长的文本,我们需要在堆上分配一块编译时大小未知的内存来保存内容。这意味着:
- 必须在运行时向内存分配器申请内存。
- 使用完
String后,我们需要一种将这块内存归还给分配器的方式。
第一部分由我们完成:调用 String::from 时,它的实现会申请所需内存。这在各种编程语言中都很常见。
不过,第二部分有所不同。在带有垃圾回收器(GC)的语言中,GC 会追踪并清理不再使用的内存,我们无需操心。在大多数没有 GC 的语言中,我们有责任判断内存何时不再使用,并像申请内存时那样调用代码显式释放它。历史上,正确完成这件事一直是一个棘手的编程问题。如果忘记释放,就会浪费内存;释放得太早,会得到无效变量;释放两次也会造成 bug。必须确保每次 allocate 都恰好对应一次 free。
Rust 采用了不同的方式:拥有内存的变量离开作用域后,内存就会自动归还。下面将代码清单 4-1 的作用域示例改为使用 String,而不是字符串字面量:
fn main() {
    {
        let s = String::from("hello"); // s is valid from this point forward

        // do stuff with s
    }                                  // this scope is now over, and s is no
                                       // longer valid
}
我们可以在一个自然的时机将 String 所需的内存归还给分配器:当 s 离开作用域时。变量离开作用域后,Rust 会为我们调用一个特殊函数。这个函数叫作 drop,String 的作者可以在其中编写归还内存的代码。Rust 会在遇到闭合花括号时自动调用 drop。
注意:在 C++ 中,这种在对象生命周期结束时释放资源的模式有时称为资源获取即初始化(RAII)。如果你使用过 RAII 模式,就会对 Rust 中的 drop 函数感到熟悉。
这种模式对 Rust 代码的编写方式有着深远影响。现在看起来或许很简单,但在更复杂的情况下,如果多个变量要使用我们分配在堆上的数据,代码行为可能会出乎意料。接下来我们就来探索其中一些情况。
变量与数据:移动
在 Rust 中,多个变量可以通过不同方式与同一份数据交互。代码清单 4-2 展示了一个使用整数的例子。
fn main() {
    let x = 5;
    let y = x;
}x 的整数值赋给 y我们大概能猜出这段代码的作用:“将值 5 绑定到 x,然后复制 x 中的值并绑定到 y。”现在我们有两个变量 x 和 y,它们的值都是 5。实际情况确实如此,因为整数是大小已知且固定的简单值,这两个 5 都会被压入栈中。
现在来看 String 版本:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
}
这看起来很相似,因此我们可能会认为它的工作方式也一样:第二行会复制 s1 中的值并绑定到 s2。但实际情况并不完全如此。
请看图 4-1,了解 String 底层的工作方式。左侧展示了 String 的三个组成部分:指向字符串内容所在内存的指针、长度和容量。这组数据存储在栈上。右侧则是堆中保存字符串内容的内存。
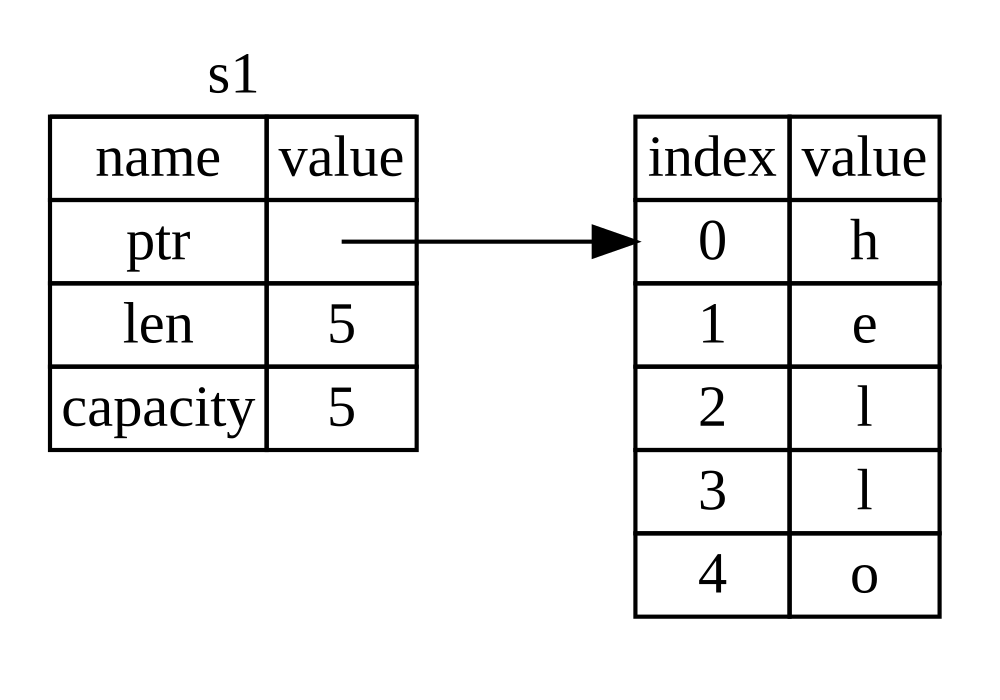
图 4-1:绑定到 s1、值为 "hello" 的 String 在内存中的表示
长度表示 String 当前内容占用了多少字节的内存。容量表示 String 从分配器获得的内存总量(以字节为单位)。长度和容量之间的区别很重要,但在这里暂时可以忽略容量。
将 s1 赋给 s2 时,会复制 String 数据,也就是说复制栈上的指针、长度和容量,但不会复制指针指向的堆数据。换句话说,内存中的数据表示如图 4-2 所示。
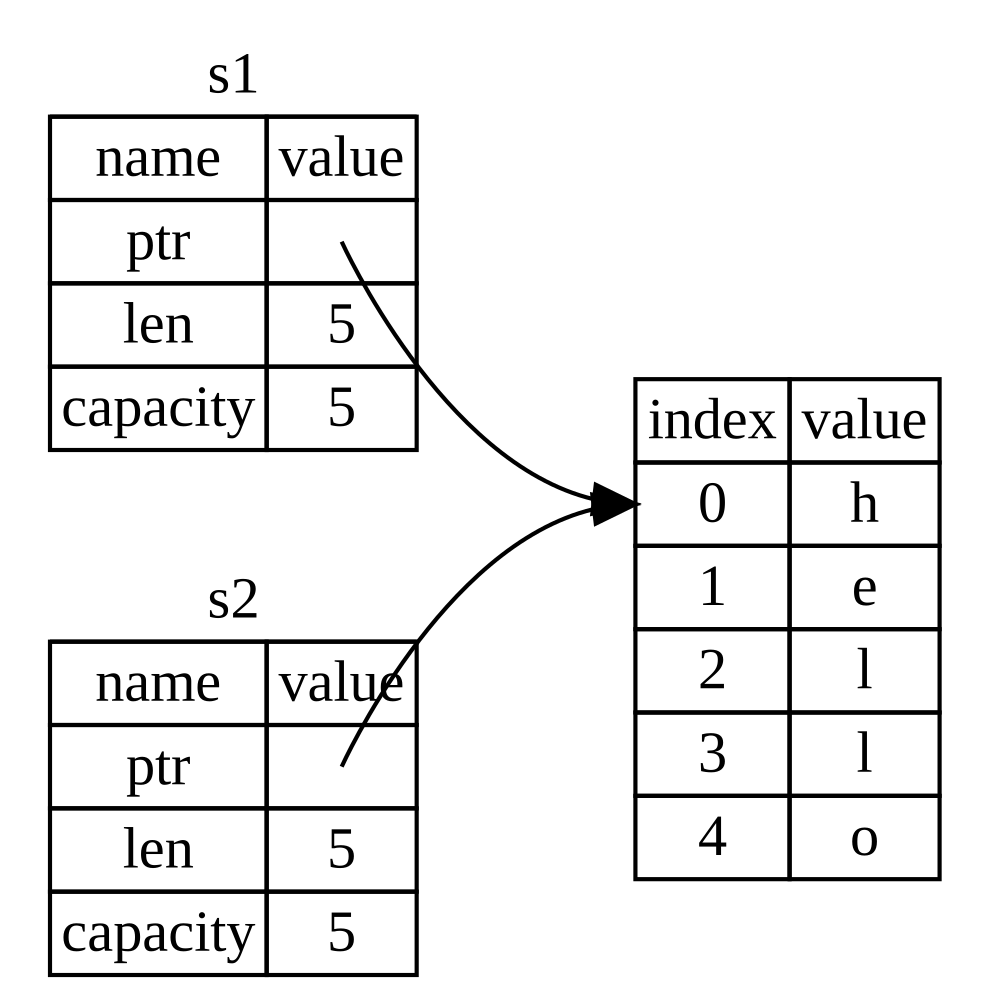
图 4-2:变量 s2 在内存中的表示,它复制了 s1 的指针、长度和容量
这种表示不是图 4-3 所示的样子;如果 Rust 也复制堆数据,内存才会是那种布局。如果堆数据很大,这样做会让 s2 = s1 操作的运行时开销非常高。
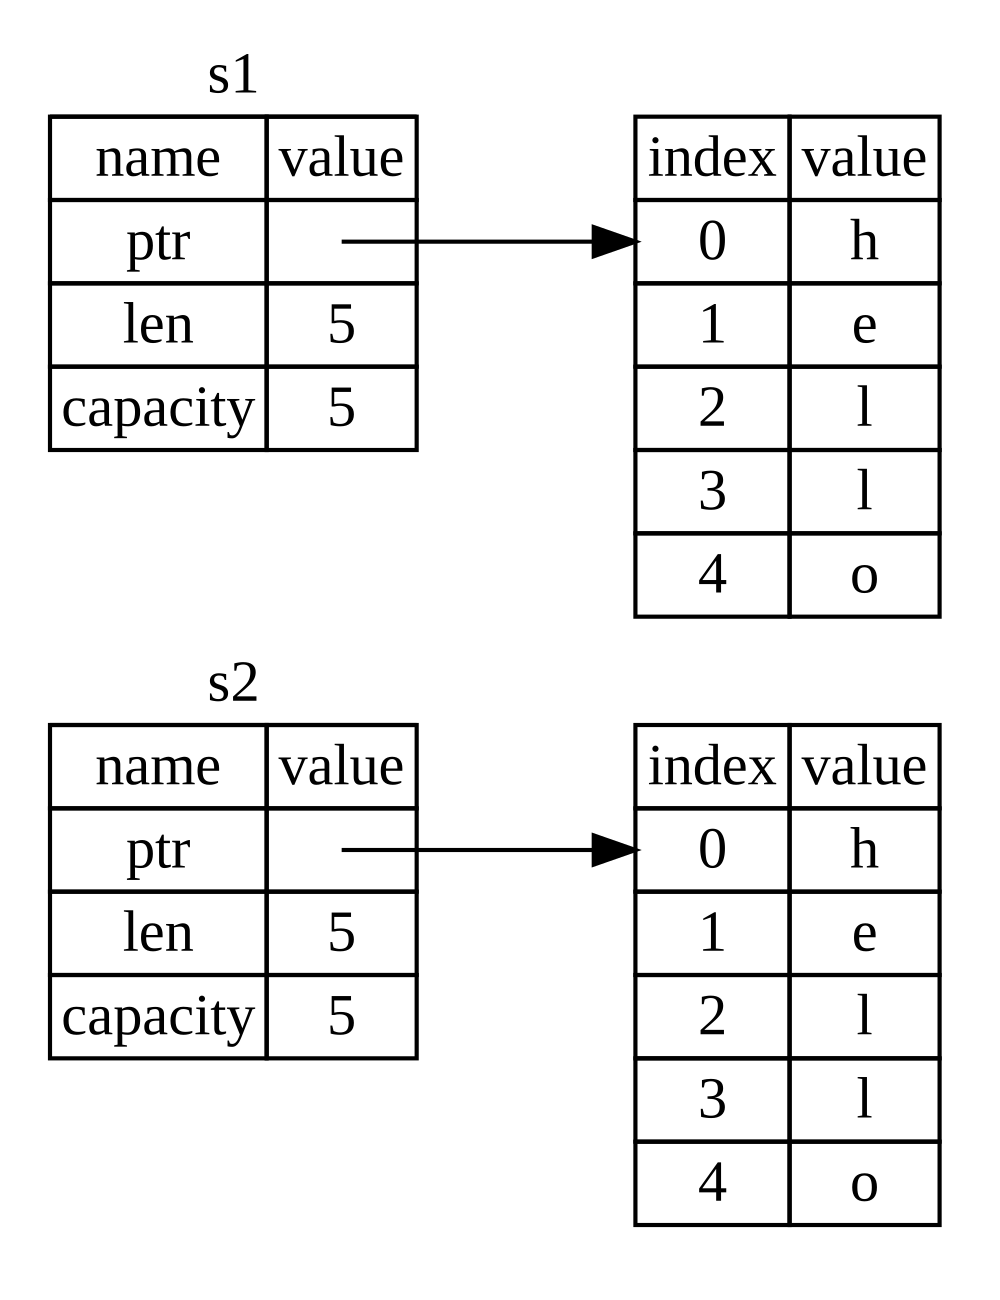
图 4-3:如果 Rust 也复制堆数据,s2 = s1 可能产生的另一种结果
前面提到,变量离开作用域时,Rust 会自动调用 drop 函数并清理该变量对应的堆内存。但图 4-2 显示,两个数据指针都指向同一位置。这就带来了问题:s2 和 s1 离开作用域时,都会尝试释放同一块内存。这称为二次释放错误,是我们前面提到的一种内存
这也是前面提到的内存安全 bug 之一。重复释放内存可能导致内存损坏,进而引发安全漏洞。
为了确保内存安全,在 let s2 = s1; 这一行之后,Rust 会认为 s1 不再有效。因此,s1 离开作用域时,Rust 不需要再释放任何内容。试着在创建 s2 后继续使用 s1,看看会发生什么:这行不通。
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;

    println!("{s1}, world!");
}
你会得到类似下面的错误,因为 Rust 会阻止你使用已经失效的引用:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0382]: borrow of moved value: `s1`
 --> src/main.rs:5:16
  |
2 |     let s1 = String::from("hello");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
3 |     let s2 = s1;
  |              -- value moved here
4 |
5 |     println!("{s1}, world!");
  |                ^^ value borrowed here after move
  |
help: consider cloning the value if the performance cost is acceptable
  |
3 |     let s2 = s1.clone();
  |                ++++++++

For more information about this error, try `rustc --explain E0382`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
如果你在使用其他语言时听说过浅复制和深复制,那么只复制指针、长度和容量,而不复制数据的做法听起来可能像浅复制。但由于 Rust 还会使第一个变量失效,这种操作不称为浅复制,而称为移动(move)。在本例中,我们会说 s1 被移动到了 s2。图 4-4 展示了实际发生的情况。
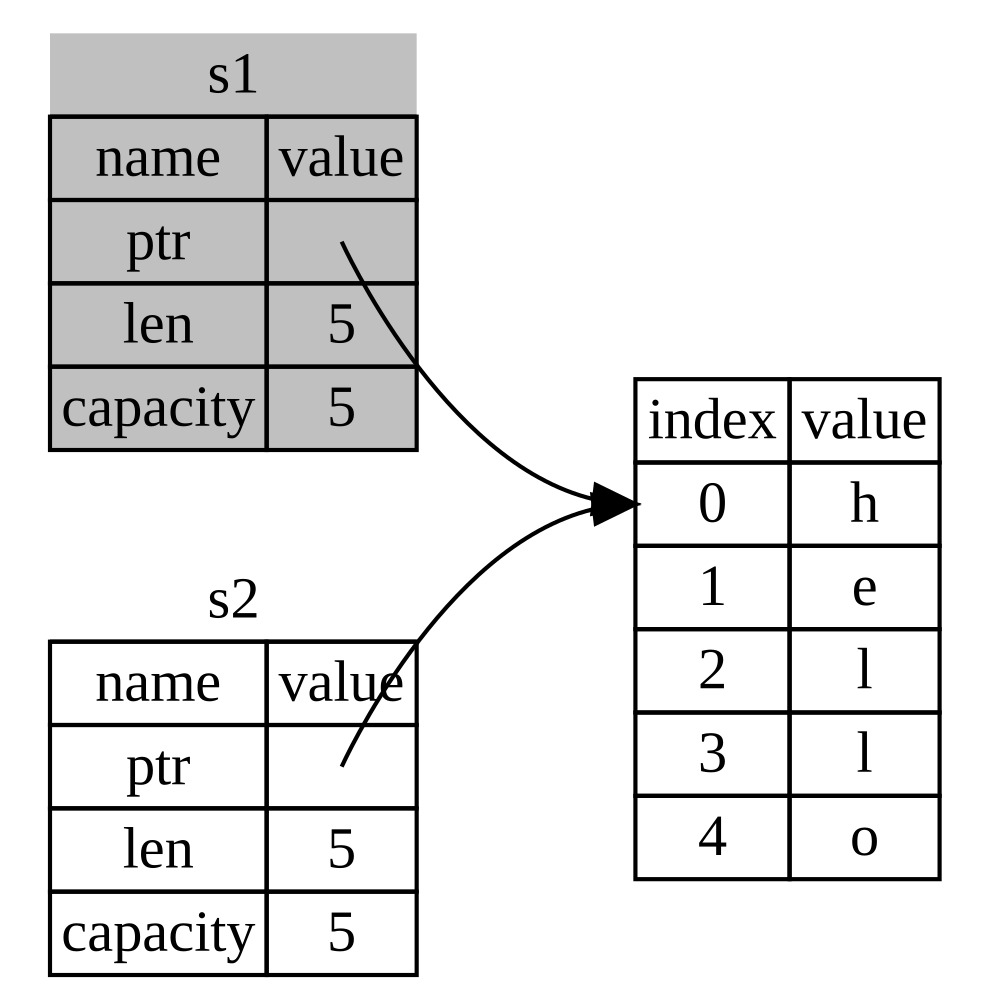
图 4-4:s1 失效后的内存表示
这样就解决了问题!只有 s2 有效,因此它离开作用域时会单独释放内存,问题就解决了。
这还隐含着一项设计选择:Rust 永远不会自动创建数据的“深”副本。因此,任何自动复制都可以认为运行时开销很低。
作用域与赋值
作用域、所有权和通过 drop 释放内存之间的关系也有相反的一面。将一个全新的值赋给现有变量时,Rust 会立即调用 drop,释放原值占用的内存。例如,看看下面的代码:
fn main() {
    let mut s = String::from("hello");
    s = String::from("ahoy");

    println!("{s}, world!");
}
我们先声明变量 s,并将它绑定到值为 "hello" 的 String。然后立即创建一个值为 "ahoy" 的新 String,并将它赋给 s。此时,已经没有任何内容引用堆上的原始值。图 4-5 展示了此时栈和堆中的数据:
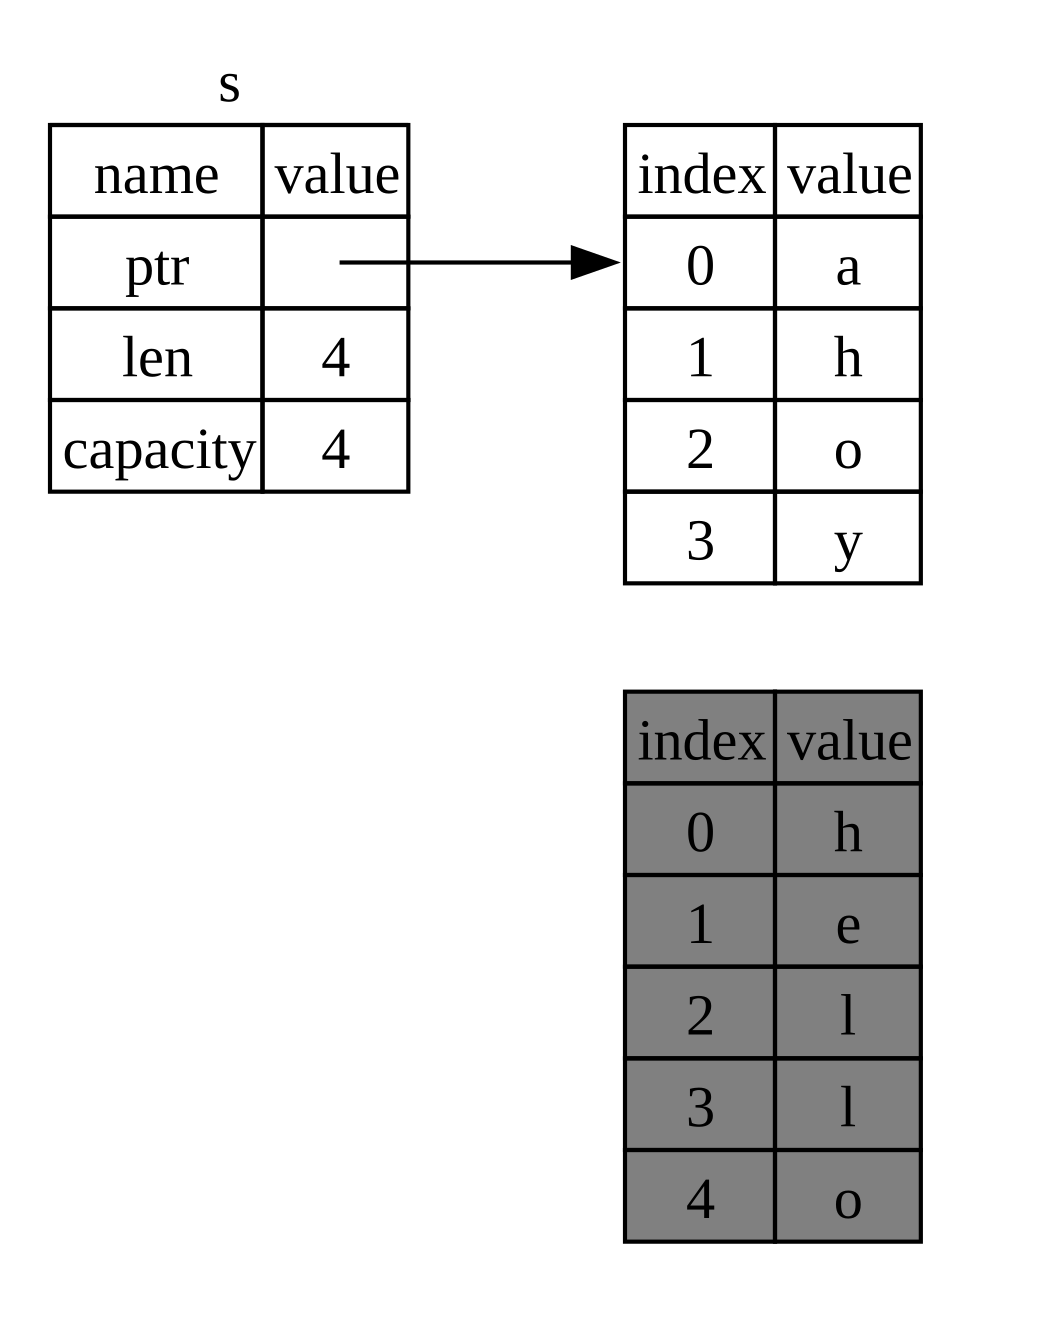
图 4-5:初始值被完全替换后的内存表示
因此,原字符串会立即离开作用域。Rust 会对它运行 drop 函数,并马上释放其内存。最后打印的值将是 "ahoy, world!"。
变量与数据:clone
如果我们确实想深度复制 String 的堆数据,而不仅仅复制栈数据,可以使用一种常见方法:clone。我们会在第 5 章讨论方法语法;不过方法在许多编程语言中都很常见,你可能已经见过。
下面是使用 clone 方法的例子:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1.clone();

    println!("s1 = {s1}, s2 = {s2}");
}
这段代码完全可行,并明确实现了图 4-3 所示的行为:堆数据确实被复制了。
看到 clone 调用时,你就知道正在执行某些具体代码,而且这些代码可能开销很大。这是一个可视化提示,表明这里发生了不同寻常的操作。
仅存储在栈上的数据:Copy
还有一个我们尚未讨论的细节。下面这段使用整数的代码(部分内容曾在代码清单 4-2 中展示)是有效的:
fn main() {
    let x = 5;
    let y = x;

    println!("x = {x}, y = {y}");
}
但这段代码似乎与我们刚学到的内容矛盾:没有调用 clone,x 却仍然有效,并没有被移动到 y。
原因是整数等编译时大小已知的类型完全存储在栈上,因此复制实际值的速度很快。也就是说,创建变量 y 后,没有理由禁止 x 继续有效。换句话说,这种情况下深复制和浅复制没有区别;调用 clone 并不会带来不同于常规浅复制的行为,所以可以省略。
Rust 有一种特殊标注,称为 Copy trait,可以用于存储在栈上的类型,例如整数(我们会在第 10 章进一步讨论 trait)。如果类型实现了 Copy trait,使用该类型的变量就不会被移动,而是会被简单复制,因此赋值给另一个变量后仍然有效。
如果某个类型或其任一组成部分实现了 Drop trait,Rust 就不允许为该类型标注 Copy。如果值离开作用域时需要执行特殊操作,而我们又为类型添加了 Copy 标注,就会在编译时出错。要了解如何为自己的类型添加 Copy 标注以实现该 trait,请参阅附录 C 的“可派生的 trait”。
那么,哪些类型实现了 Copy trait?你可以查阅相应类型的文档来确认;一般来说,简单标量值的组合都可以实现 Copy,而任何需要分配内存或属于某种资源的类型都不能实现 Copy。以下是一些实现了 Copy 的类型:
- 所有整数类型,例如
u32。 - 布尔类型
bool,其值为true和false。 - 所有浮点类型,例如
f64。 - 字符类型
char。 - 仅包含也实现了
Copy类型的元组。例如,(i32, i32)实现了Copy,但(i32, String)没有实现。
所有权与函数
向函数传递值的机制与将值赋给变量类似。把变量传给函数时,也会像赋值一样发生移动或复制。代码清单 4-3 中的示例标注了变量进入和离开作用域的位置。
fn main() {
    let s = String::from("hello");  // s comes into scope

    takes_ownership(s);             // s's value moves into the function...
                                    // ... and so is no longer valid here

    let x = 5;                      // x comes into scope

    makes_copy(x);                  // Because i32 implements the Copy trait,
                                    // x does NOT move into the function,
                                    // so it's okay to use x afterward.

} // Here, x goes out of scope, then s. However, because s's value was moved,
  // nothing special happens.

fn takes_ownership(some_string: String) { // some_string comes into scope
    println!("{some_string}");
} // Here, some_string goes out of scope and `drop` is called. The backing
  // memory is freed.

fn makes_copy(some_integer: i32) { // some_integer comes into scope
    println!("{some_integer}");
} // Here, some_integer goes out of scope. Nothing special happens.如果在调用 takes_ownership 后尝试使用 s,Rust 会在编译时抛出错误。这些静态检查能保护我们免于犯错。试着在 main 中添加使用 s 和 x 的代码,看看哪些情况下可以使用它们,哪些情况下所有权规则会阻止你这样做。
返回值与作用域
返回值也可以转移所有权。代码清单 4-4 展示了一个返回值的函数,并像代码清单 4-3 一样标注了相关信息。
fn main() {
    let s1 = gives_ownership();        // gives_ownership moves its return
                                       // value into s1

    let s2 = String::from("hello");    // s2 comes into scope

    let s3 = takes_and_gives_back(s2); // s2 is moved into
                                       // takes_and_gives_back, which also
                                       // moves its return value into s3
} // Here, s3 goes out of scope and is dropped. s2 was moved, so nothing
  // happens. s1 goes out of scope and is dropped.

fn gives_ownership() -> String {       // gives_ownership will move its
                                       // return value into the function
                                       // that calls it

    let some_string = String::from("yours"); // some_string comes into scope

    some_string                        // some_string is returned and
                                       // moves out to the calling
                                       // function
}

// This function takes a String and returns a String.
fn takes_and_gives_back(a_string: String) -> String {
    // a_string comes into
    // scope

    a_string  // a_string is returned and moves out to the calling function
}变量所有权每次都遵循相同的模式:将值赋给另一个变量会导致移动。包含堆数据的变量离开作用域时,如果数据所有权没有转移给其他变量,该值就会由 drop 清理。
虽然这种方式可行,但每次调用函数都接收并返回所有权,有些繁琐。如果我们只想让函数使用某个值,却不想转移所有权,该怎么办?如果还想再次使用传入的值,就必须把它传回来,此外还要返回函数体产生的其他结果,这确实很麻烦。
Rust 允许我们使用元组返回多个值,如代码清单 4-5 所示。
fn main() {
    let s1 = String::from("hello");

    let (s2, len) = calculate_length(s1);

    println!("The length of '{s2}' is {len}.");
}

fn calculate_length(s: String) -> (String, usize) {
    let length = s.len(); // len() returns the length of a String

    (s, length)
}不过,对一个很常见的需求来说,这样做太繁琐、工作量也太大了。幸运的是,Rust 提供了一项无需转移所有权就能使用值的功能:引用。